HyperAI
Command Palette
Search for a command to run...
Papers
Daily updated cutting-edge AI research papers to help you keep up with the latest AI trends
papers
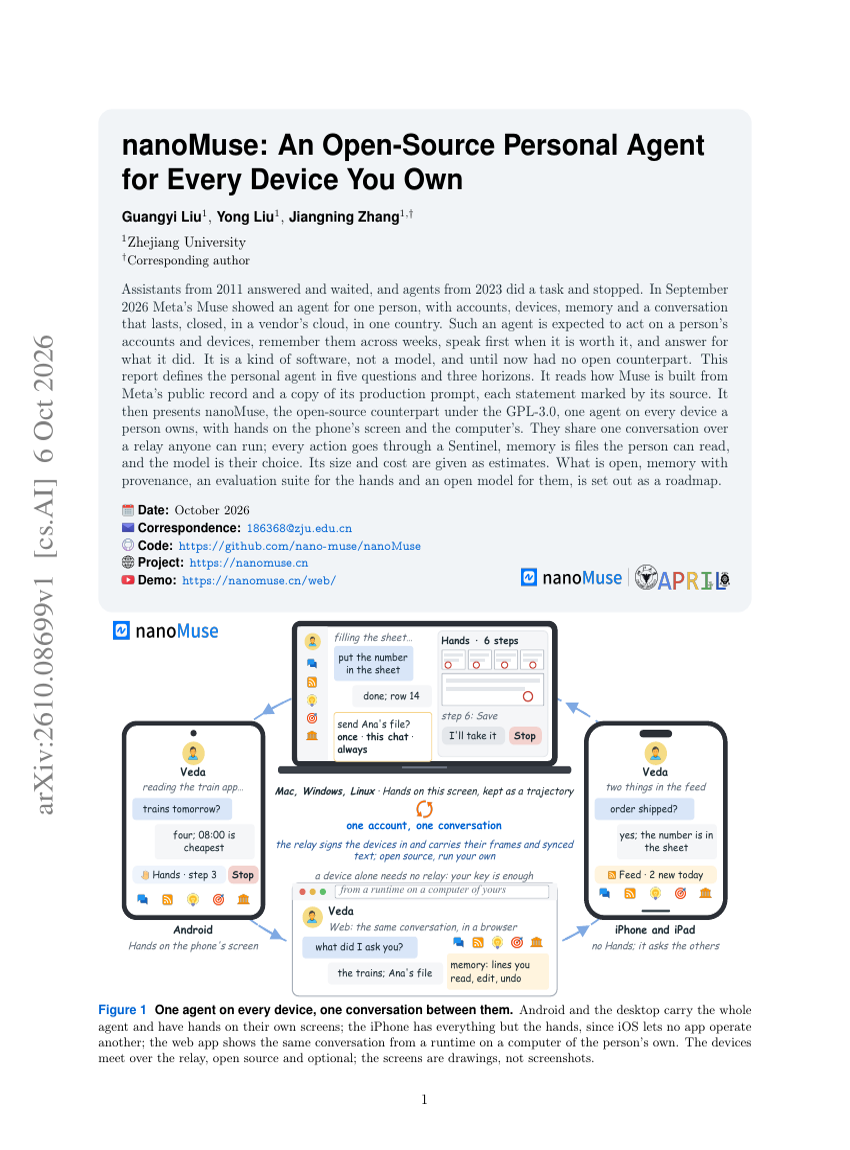
nanoMuse: An Open-Source Personal Agent for Every Device You Own
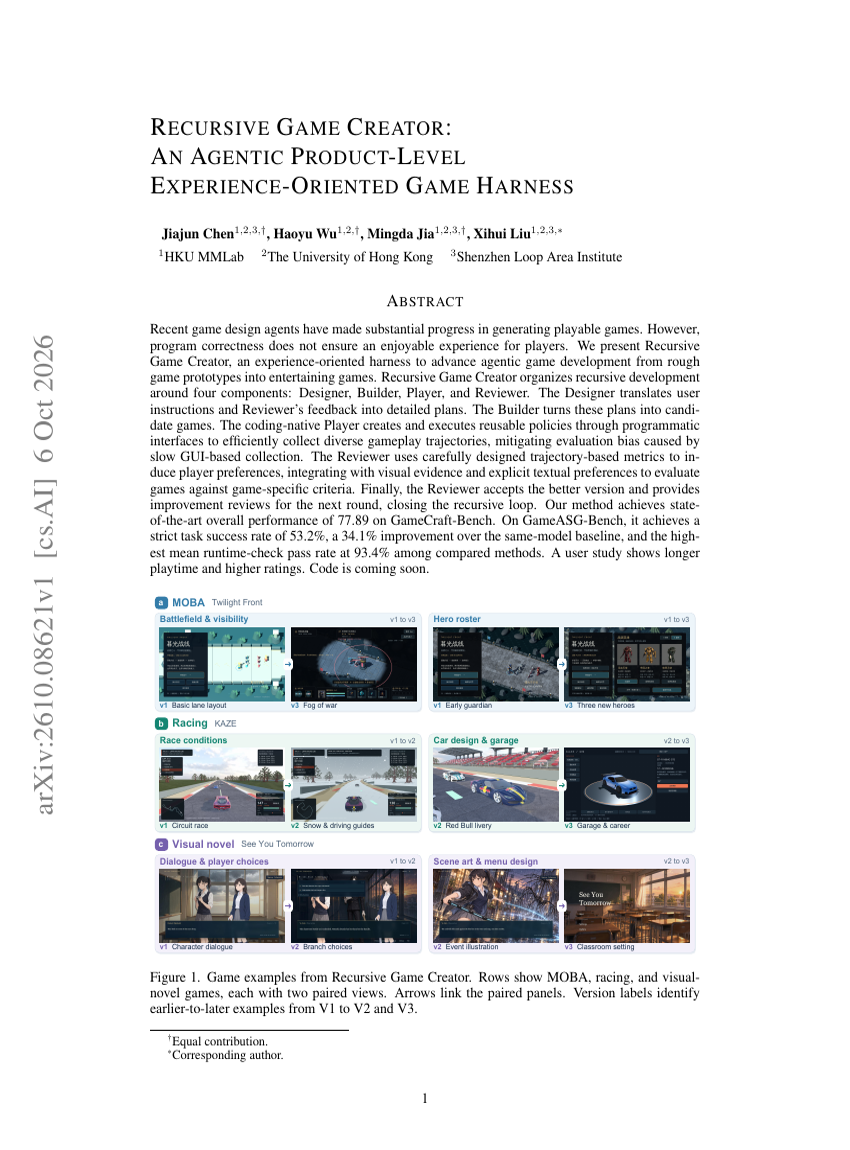
RECURSIVE GAME CREATOR: AN AGENTIC PRODUCT-LEVEL EXPERIENCE-ORIENTED GAME HARNESS
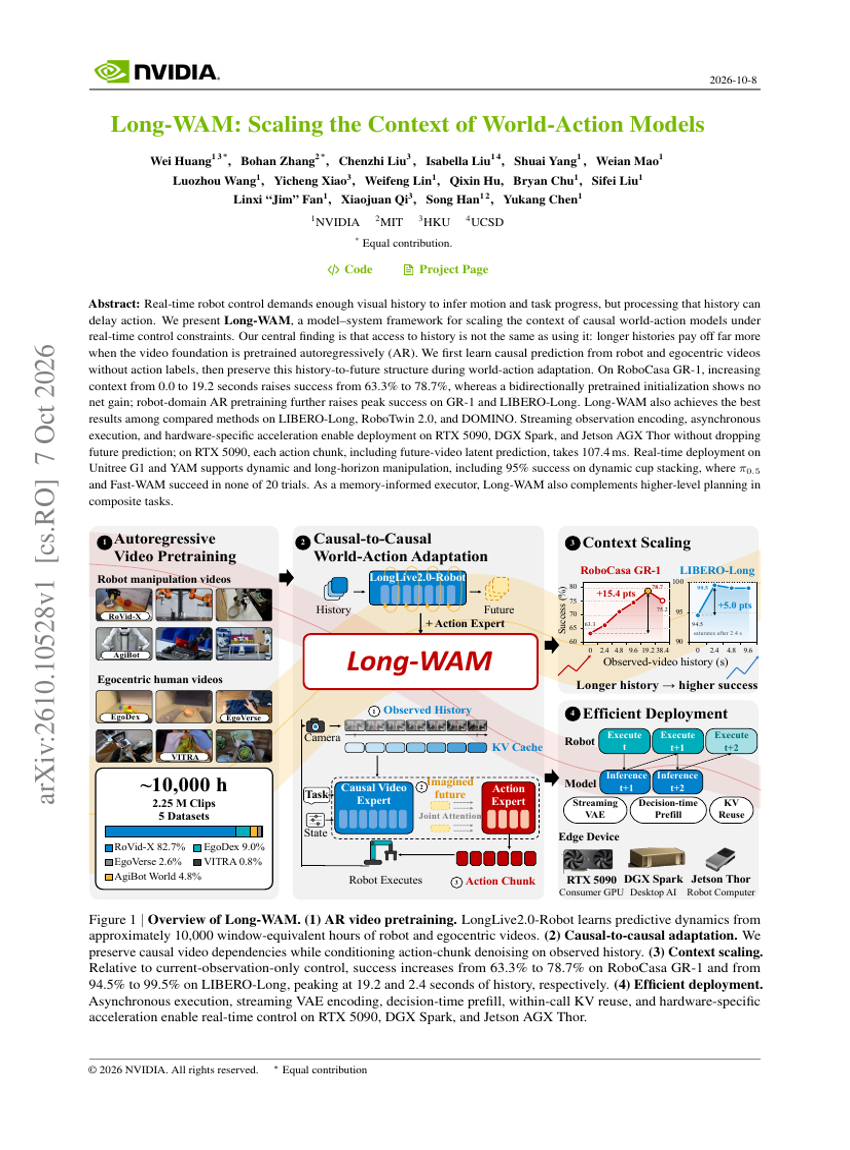
Long-WAM: Scaling the Context of World-Action Models
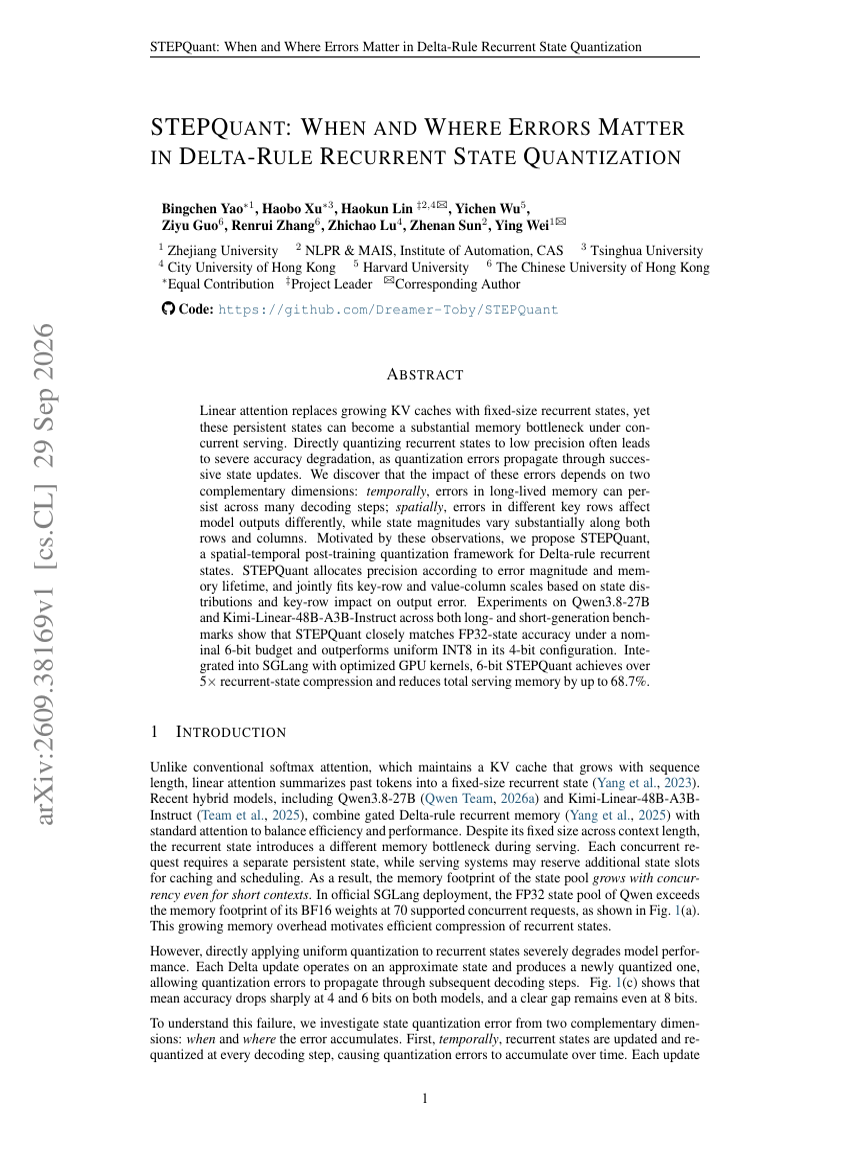
STEPQUANT: WHEN AND WHERE ERRORS MATTER IN DELTA-RULE RECURRENT STATE QUANTIZATION
WING: World Action Learning via INteraction-Centric Spectral Latent Guidance
FROM EVIDENCE TO ACTION: HOW TOOL-USING AGENTS FAIL
EVISKILL: GROUNDING SKILL EVOLUTION IN RE-PLAYABLE EVIDENCE
TRACE: Rollout-Guided Quantization-Aware Training for FP4 Reinforcement Learning of MoE Language Models
DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation
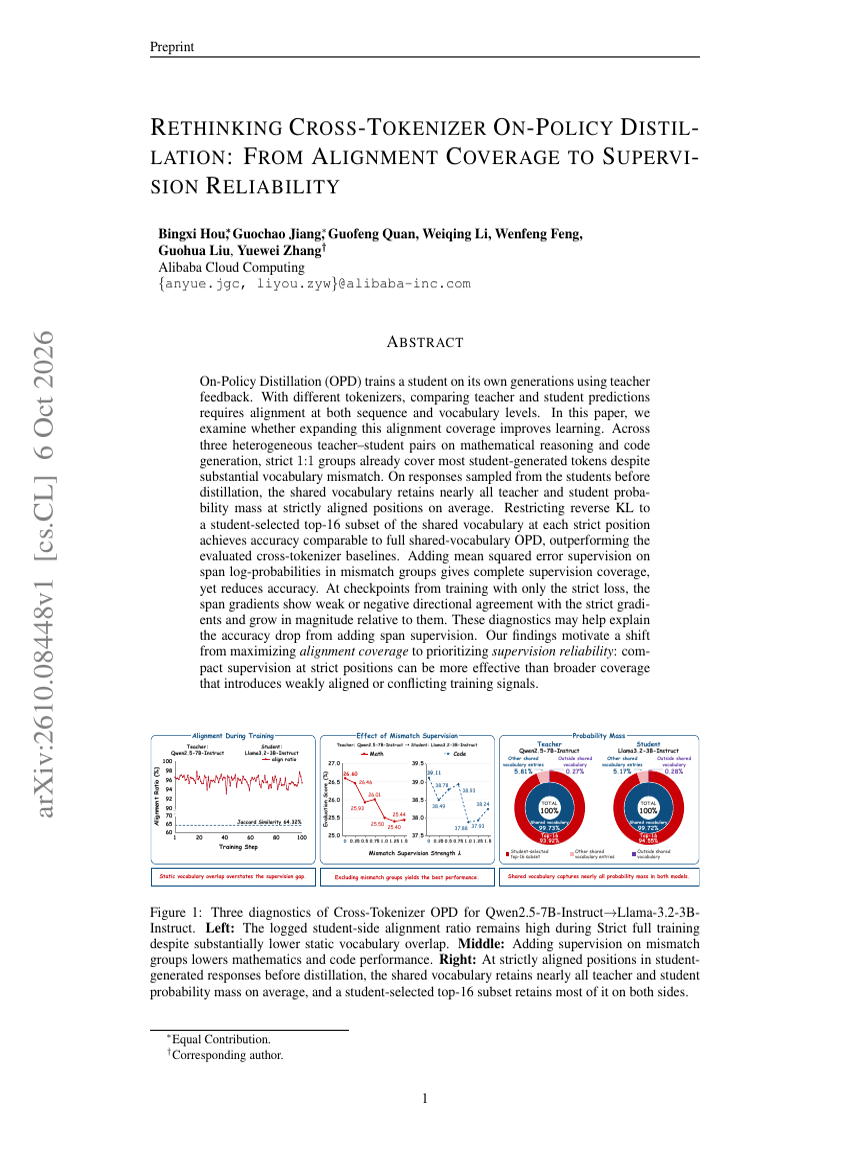
RETHINKING CROSS-TOKENIZER ON-POLICY DISTILLATION: FROM ALIGNMENT COVERAGE TO SUPERVISION RELIABILITY
OPTIMIZING THE OPTIMIZER: LANGUAGE MODELS DISCOVER FASTER MOLECULAR RELAXATION
FOUNDATIONS OF PROACTIVE AGENTS: PRINCIPLES, TECHNICAL LAYERS, AND PROACTIVITY-GYM
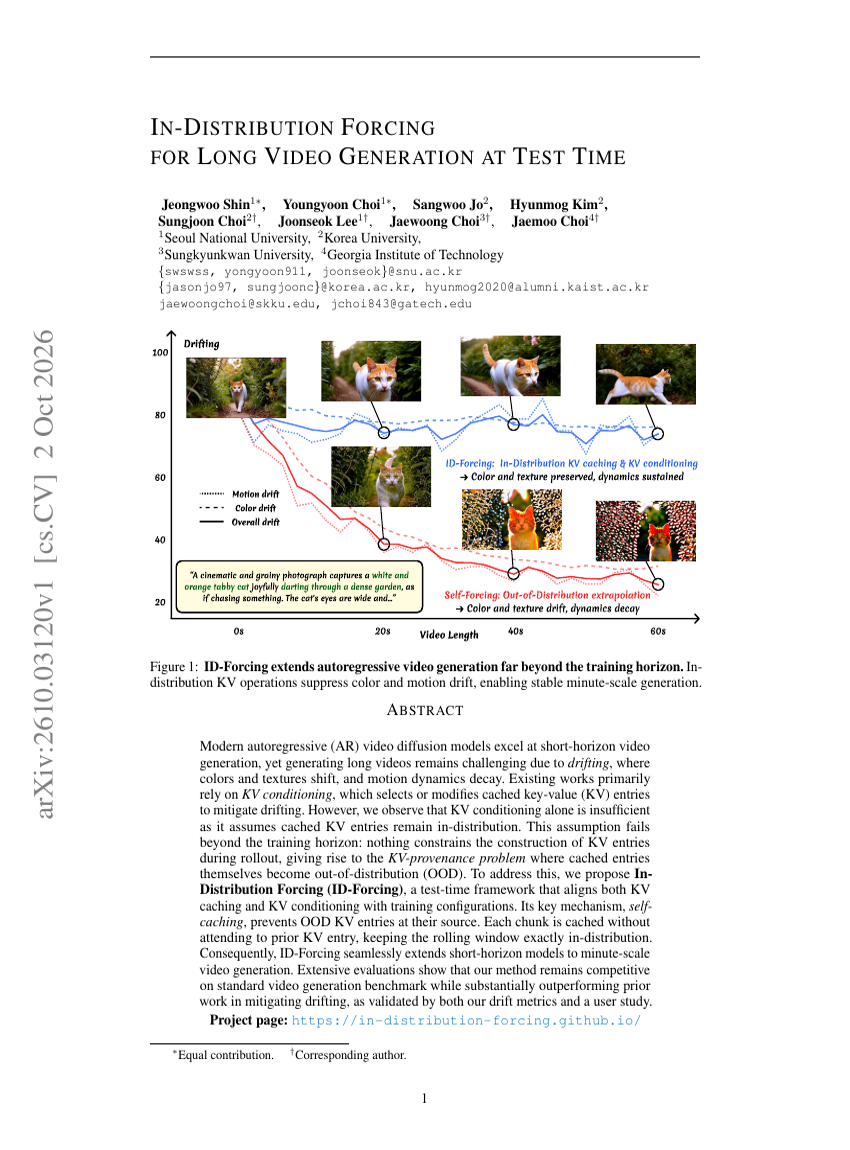
IN-DISTRIBUTION FORCING FOR LONG VIDEO GENERATION AT TEST TIME
MEMADAPTER: COUNTERFACTUAL ADAPTATION AGAINST MEMORY-INDUCED SYCOPHANCY
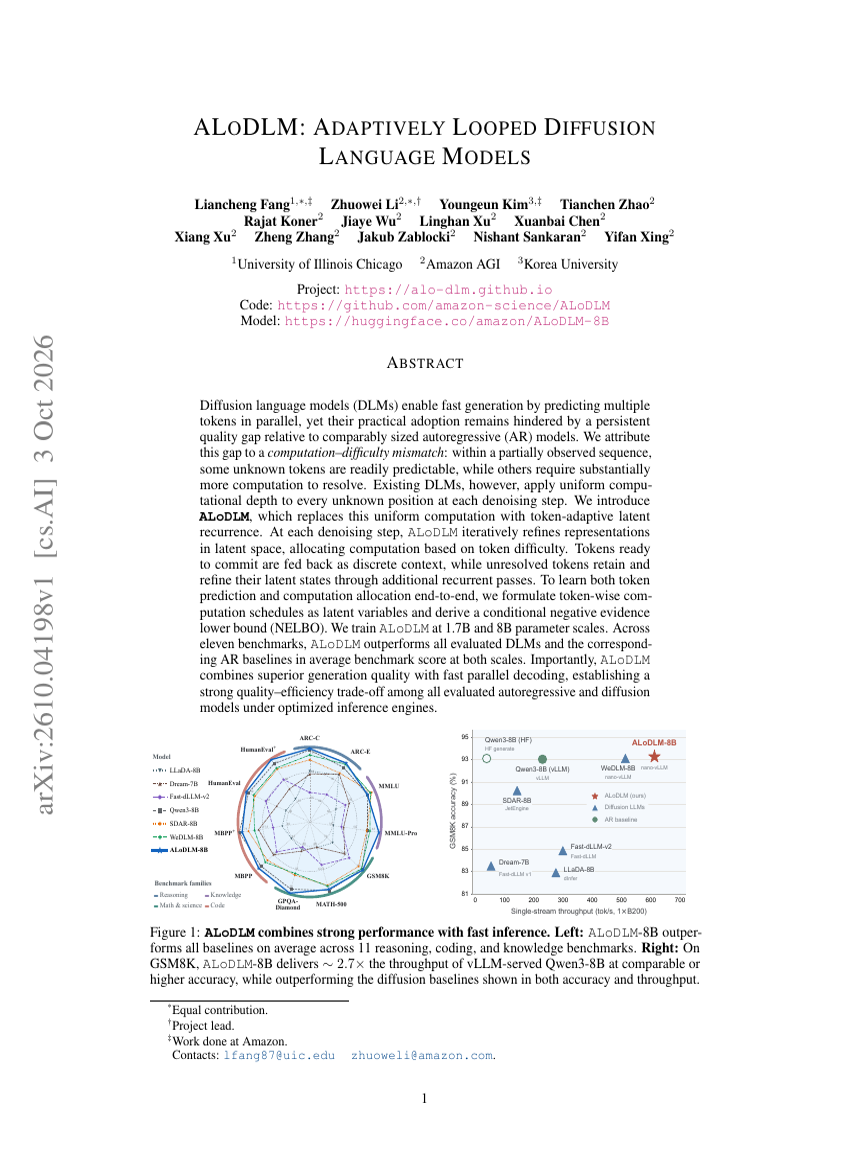
ALODLM: ADAPTIVELY LOOPED DIFFUSION LANGUAGE MODELS
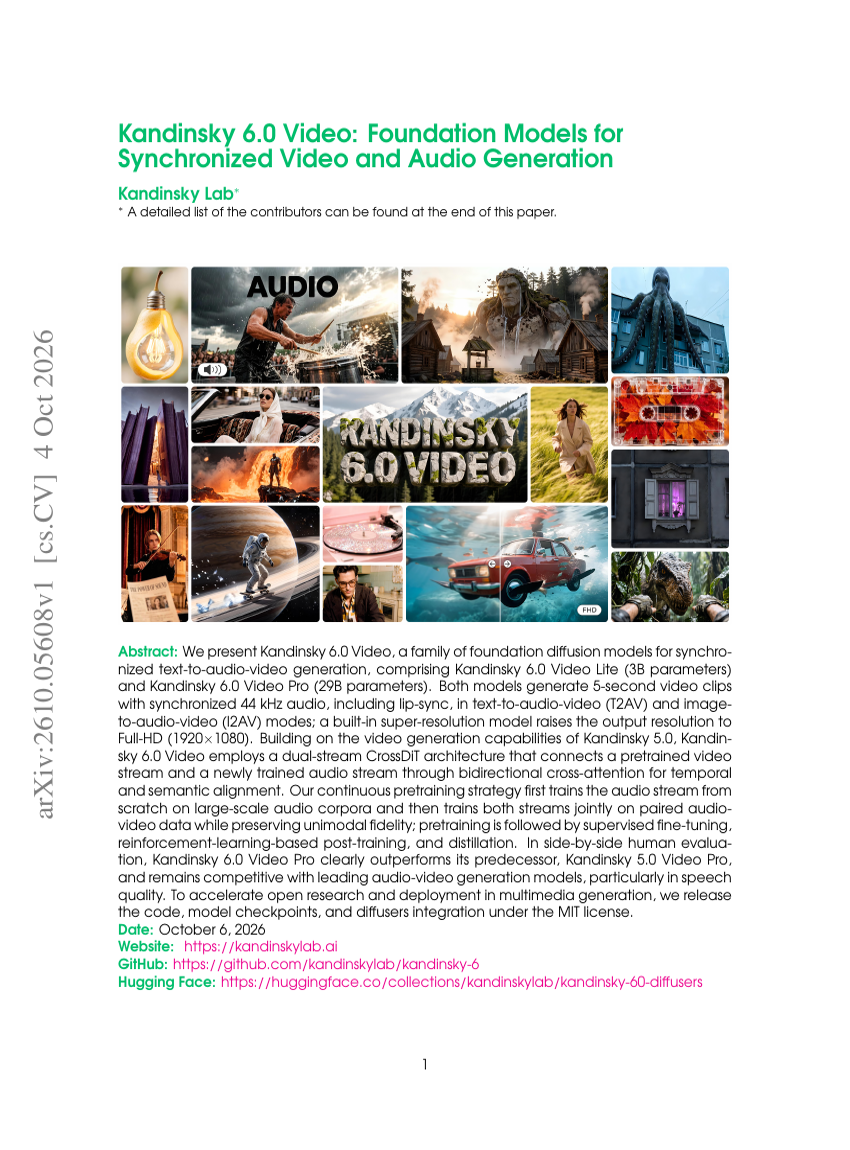
Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
On-Policy Parameter Update Direction Underlies Generalization in LLM Post-Training
World Action Modeling with Progressive Visual Planning
Scaling Trajectories for Complex Tasks through Recursive Self-Rewrite
FRAMEMORROW: FUTURE-GUIDED FRAME SELECTION WITH PROSPECTIVE TOKENS FOR LONG-HORIZON VIDEO GENERATION
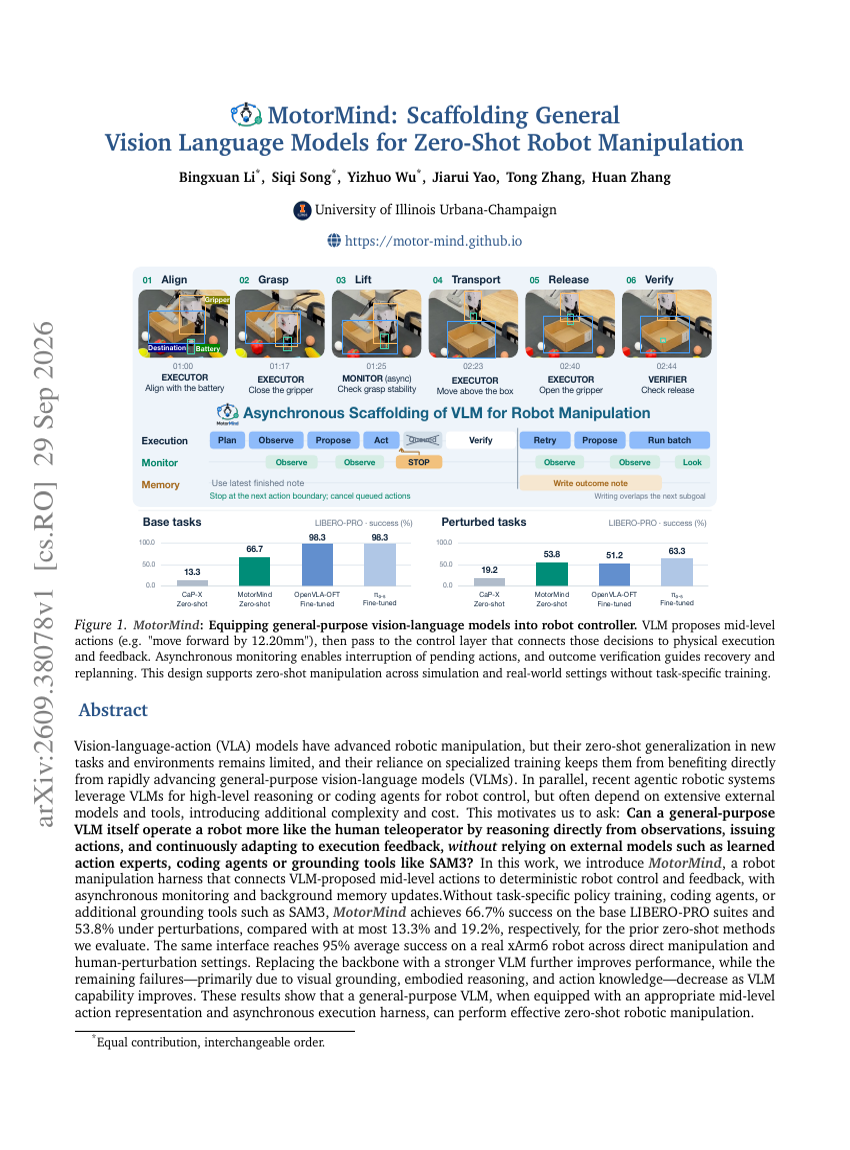
MotorMind: Scafolding General Vision Language Models for Zero-Shot Robot Manipulation
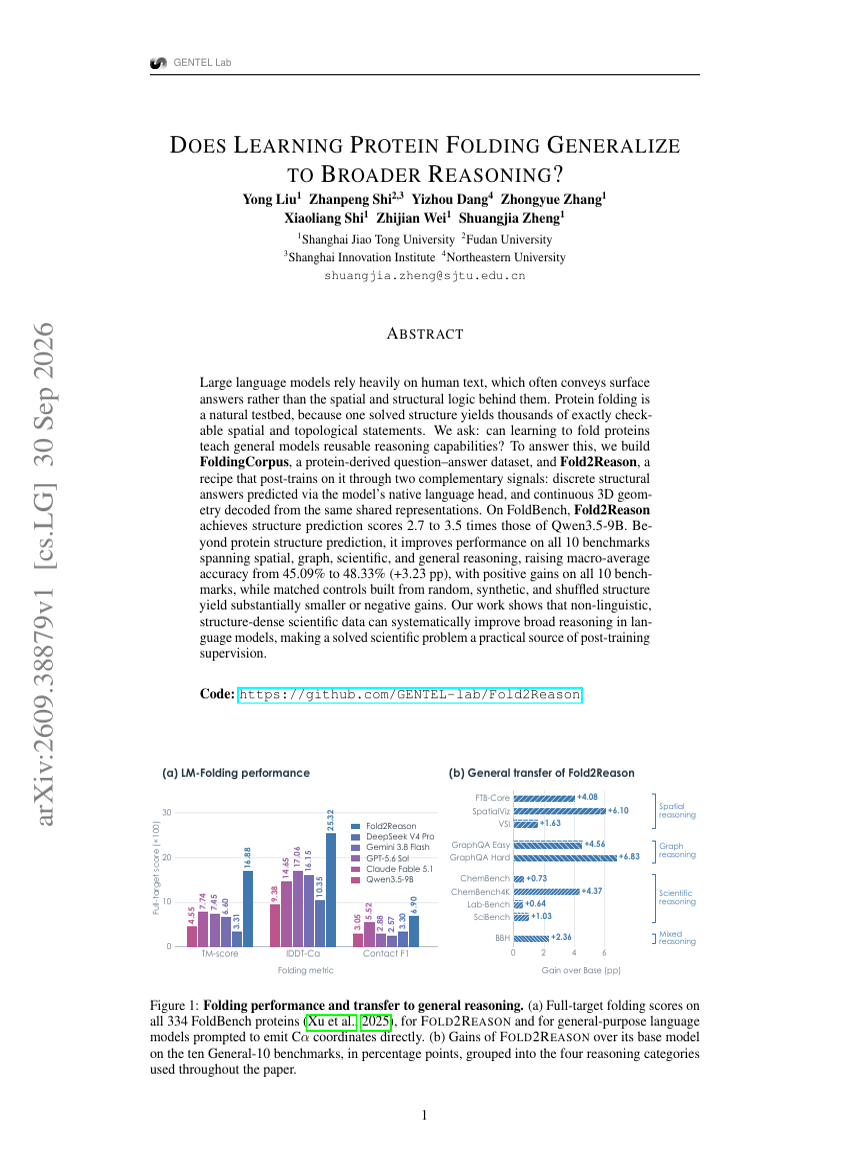
DOES LEARNING PROTEIN FOLDING GENERALIZE TO BROADER REASONING?
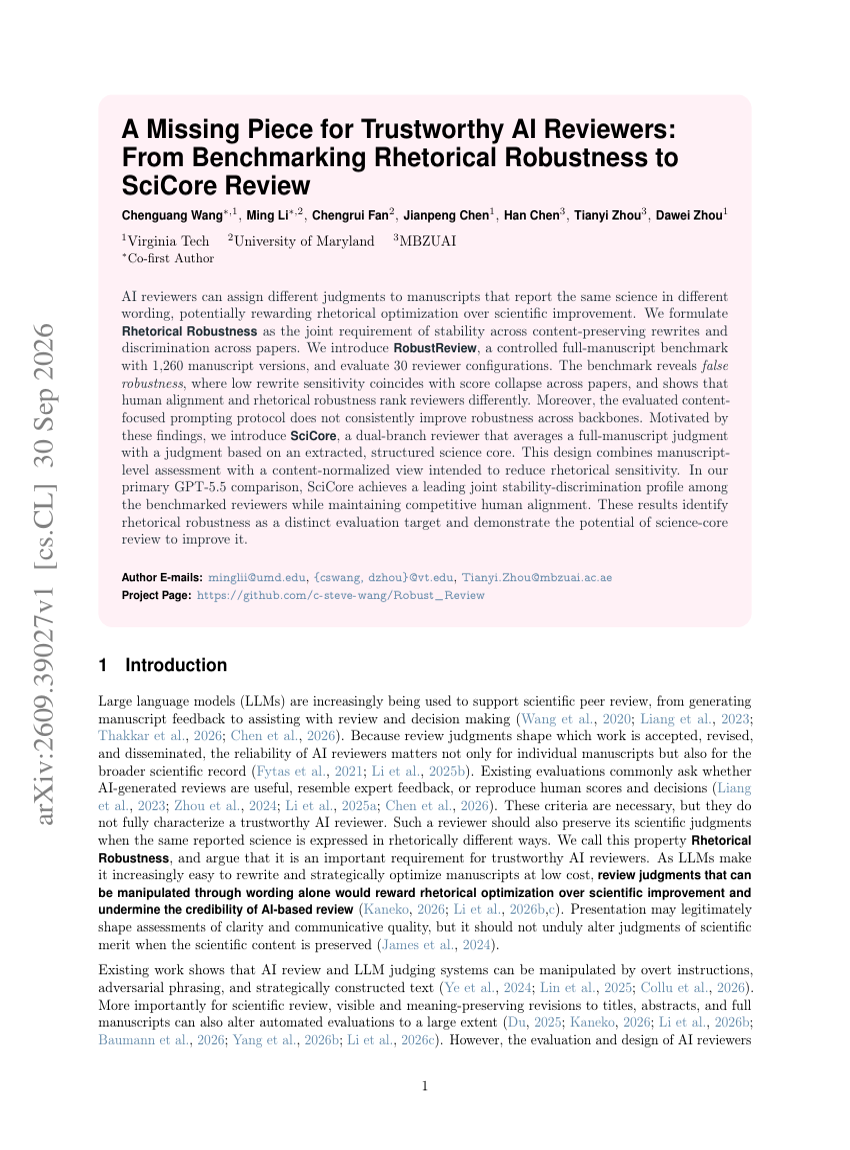
A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review
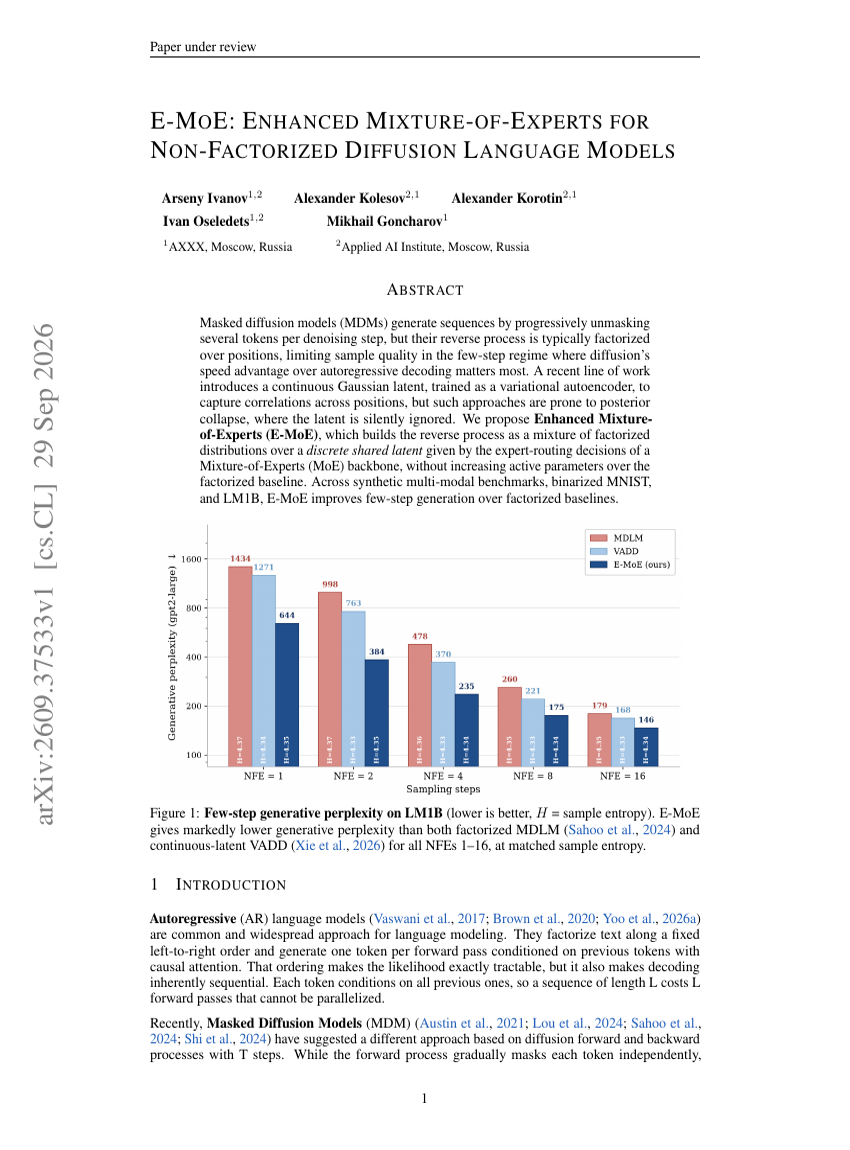
E-MOE: ENHANCED MIXTURE-OF-EXPERTS FOR NON-FACTORIZED DIFFUSION LANGUAGE MODELS
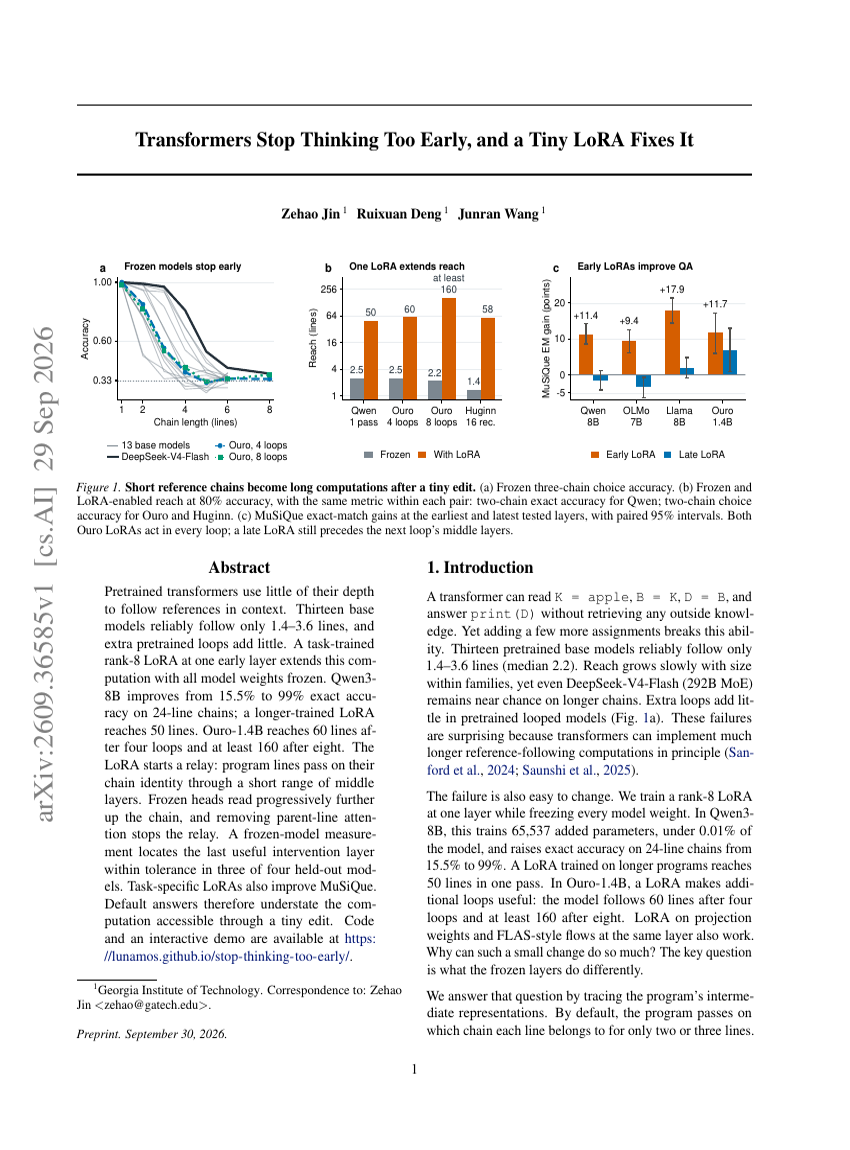
Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
ADAPTIVE REWARD ROUTING: DYNAMIC MULTI-REWARD OPTIMIZATION FOR JOINT AUDIO-VIDEO DIFFUSION VIA FORWARD-PROCESS RL
OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
ON-POLICY OR OFF-POLICY LEARNING? A SYSTEMATIC STUDY OF DISTILLATION DYNAMICS
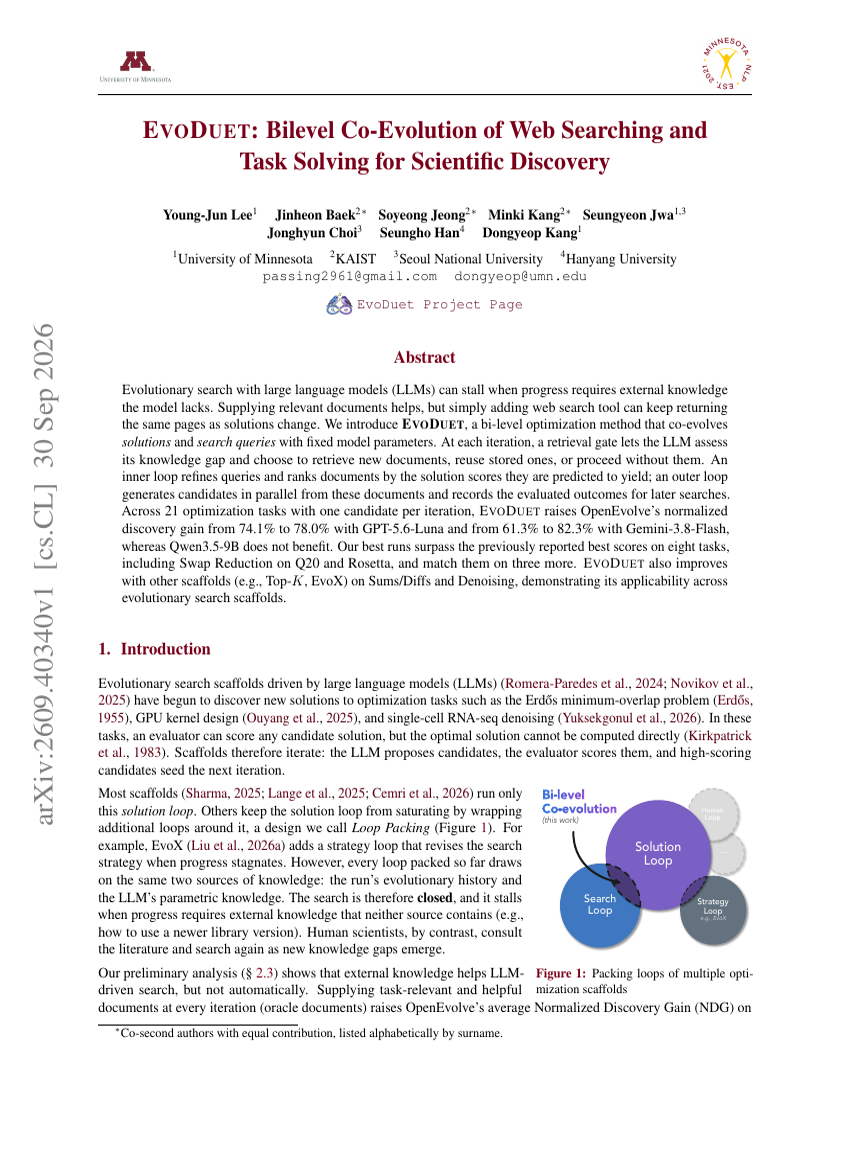
EVODUET: Bilevel Co-Evolution of Web Searching and Task Solving for Scientific Discovery
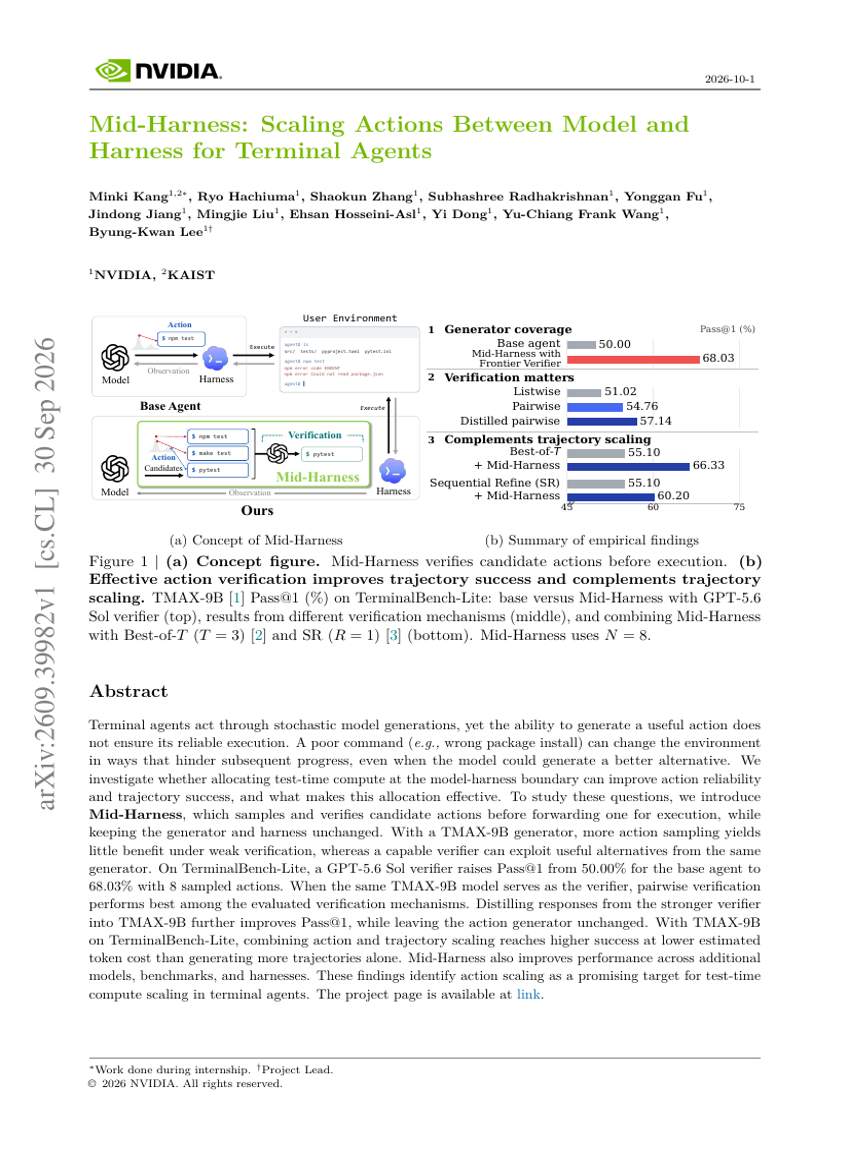
Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents